如何降低 Turnitin 相似度分数(正规方法)
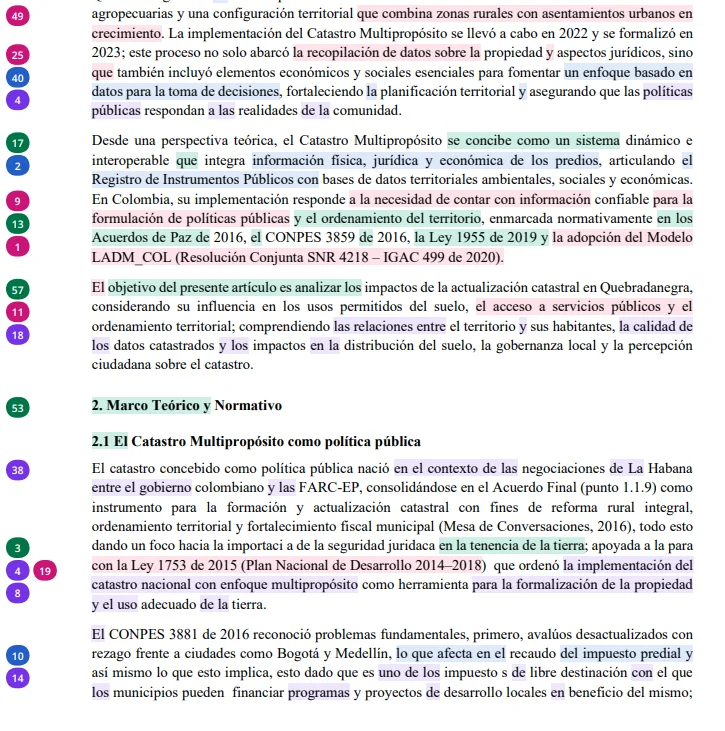
要降低 Turnitin 相似度,就修真正在匹配的东西:把直接引文放进引号并标注出处;借来的段落用自己的话重写,照样引用;删掉只为凑篇幅加的引文。同义词改写器没用——Turnitin 匹配的是连续词串,同样的句子骨架换上几个词照样标红。在我们自己的测试论文上,这三招把相似度从 50% 降到 26%,全程没用任何改写工具。
关于作者身份。我们是 InDetect 团队——一家第三方提交前检测服务,通过授权教师级 Turnitin 账号跑论文。我们当然希望你提交前先查——这和我们有关,请自行掂量。文中数字来自我们测试论文的真实报告,方法则和写作中心教的一样。
核心要点
相似度不是抄袭——报告只展示匹配的词串,哪些匹配是问题,由你判断。
三招覆盖绝大多数情况:规范引文格式、真正改写(并引用)、删掉装饰性引用。
同义词改写器会失败,因为匹配针对连续词串——而且改写过的文本还可能让人写的东西看起来像 AI。
目标是你学校的阈值(常见总相似度 15–25%),不是 0%。降过头会伤害论文。
用零入库服务拿真实报告来验证修改效果,你的草稿才会在提交时不和自己匹配。
1. 先弄清楚到底是什么在匹配
动笔重写之前,先给报告做分诊。每个匹配块会告诉你三件事:匹配到了哪里(网站、期刊文章还是另一个学生的论文),单一来源占多大,匹配是不是落在你的引文或参考文献里。
不同的匹配类型需要不同的应对。文献综述里和已发表文章匹配了 4%,多半是引文格式问题。正文段落里和单一来源匹配 9%,是改写问题——或者更糟。参考文献列表里的匹配,是可以过滤掉的噪音。
多数报告允许你排除引文、参考文献和小匹配(通常是 1% 以下或几个词以内)。看完过滤后的数字再决定要不要慌。然后看单来源那一列:教师在意的是一个 8% 的匹配,远多于散在全文的十个 1%。
搞清楚你面对的是哪类匹配,再从下面挑对应的修法。
2. 方法一:规范地引用
一段话值得逐字保留,就引用它。短引文放进引号,标上作者、年份和页码,按你需要的引用格式排好。
为什么这能改变数字:多数学校开 Turnitin 时启用了 Quote Matcher(引文匹配器)。规范引号内的文本会被识别为引文,要么从相似度总分里排除,要么单独归类。没有格式的"引用"——一句抄来的话裸在段落里、没有任何标记——在算法眼里和复制粘贴一模一样。
一条经验法则:一句话如果你不会用自己的语气说出来,就引用它。也别堆引文。一段话由四句引文拼起来,不管相似度多少,都在告诉教授你没消化过材料。
3. 方法二:真正改写
真正的改写不是换词。是把一段读到懂,合上来源,凭记忆写下观点,再打开来源检查自己没保住原文结构——无论如何都要引用。
差别在这里,用我们测试论文里的一句话:
糟糕的改写(仍然匹配): 原句"研究发现睡眠时长与学业表现之间存在显著相关"改成"研究揭示了学生睡多久和他们成绩之间的紧密联系"。骨架没变,只换了同义词。Turnitin 照样标。
真正的改写: "睡眠不足六小时的学生考试成绩更低——即使控制了学习时长也是如此(Chen, 2024)。" 句子围绕你的论点重建,引用保留。
如果你凭记忆写不出这个观点,说明你还没真正理解它——而这本来就是作业的意义所在。
4. 方法三:删掉装饰性引用
你的一部分相似度来自你根本不需要的引文。学生会在每段塞一行引文,显得读书多,或者凑引用数。每一句都是匹配文本,堆起来就把分数抬上去了。
用综合替代装饰性引文:一句话概括多个来源,一起引用。"多项研究把短睡眠和更低的考试成绩联系起来(Chen, 2024; Okafor, 2023; Reid, 2025)"比三句粘在一起的引文分析含量更高,匹配文本也少得多。
留下承担证据的引文——一个定义、一个你要反驳的观点、表述精确的数据。删掉只做装饰的。
5. 同义词改写器为什么没用(还添乱)
Turnitin 的相似度引擎匹配的是连续词串,不是单个词汇。改写器把 significant 换成 notable,却保住你的小句顺序原样,指纹还在。我们自己的测试里,改写过的段落照样被匹配。
还有第二个问题。改写过的文本趋于扁平:句子长度均匀、用词怪异、没有缩写。这种统计纹理正是 AI 写作检测器读取的东西。改写器可能一边降低你的相似度,一边把同一篇论文推向 AI 标记。真实引擎跨模型能抓到什么,我们在Gemini、ChatGPT 与 Claude 检测实测里测过;评分机制拆解在我们的Turnitin AI 检测工作原理指南里。
别用改写器。引用、改写、标注。
6. 应该降到多低?
没有普适的安全数字,任何向你承诺一个数字的人都在卖东西。先查你学校的政策。多数学校落在总相似度 15–25% 附近,单来源匹配要求很低,但各院系自己划线。
别追 0%。一篇诚实的论文会引用来源、点名共享的术语、使用本领域人人都在用的标准表述。这些匹配是正当的。我们的测试论文最终停在 26%,不是 4%——剩下的匹配都是规范引用、注明出处的材料。
降过头会害了你。往零逼近的学生删掉必要的引用、改坏术语,交出的写作比开始时更差。降到每个剩下的匹配你都解释得清,就停手。
7. 提交前先查——但别喂数据库
别猜你的修改有没有用。把改后的草稿过一遍真实引擎,对比两份报告。
学生担心的坑:先查一次,我的论文会不会进 Turnitin 库?会——如果检测器把你的草稿存进了 Turnitin 学生论文库。那你真正的提交就会和你自己存下的草稿匹配,有时高达 100%,然后你被指控自我抄袭。这就是为什么存储设置比价格更重要。
InDetect 把上传路由到配置为零入库的教师账号,5 到 30 分钟返回完整的相似度 + AI 报告,论文和报告 24 小时内删除。查草稿、修改、再查——第一次检测不会有任何东西留在数据库里等着和你的最终提交匹配。完整流程(含截图)在我们的服务实测里,提交前报告本身见我们的提交前相似度检测指南。
8. 常见问题:降低 Turnitin 相似度,实话实说
怎么又快又稳地降低 Turnitin 相似度? 给每一处直接引文加上引号和出处,凭记忆重新改写被匹配的段落(照样引用),删掉不需要的引文。这三招把我们的测试论文从 50% 降到 26%。改写器彻底别碰。
改写工具真的能降低相似度吗? 不可靠。它们换词不换句子结构,而连续词串匹配恰恰不怕这个——过程中还可能把文字磨平,带上 AI 味。
为什么换了词相似度还是高? 因为换词不等于换结构。小句顺序和句式骨架和来源一致,这个块就仍然匹配。凭记忆重建段落,或者规范地加引号引用。
相似度 20% 意味着抄袭吗? 不。相似度是匹配百分比,不是判决书。一份 20% 的报告如果全是规范引用、注明出处的材料,多数学校没问题;一份 4% 的报告里藏着一段未注明出处的抄文,就有问题。读匹配的具体内容。
降低相似度会改变我的 AI 分数吗? 这是两个独立的分数。规范引用和标注几乎不动 AI 数字。改写器驱动的重写可能把它推向反方向,因为换词后的文本读起来像模型。
9. 结语:修掉你解释不清的那些匹配
打开报告、给匹配分诊、引用、改写、删掉凑数的——然后用真实报告验证,而不是靠希望。方法就这些。我们的测试论文从 50% 到 26%,一次改写器都没点。
符合条件国家的新用户可以在 InDetect 免费检测一次;如果不止改一轮,Lite $9/月 2 次(每篇 $4.50),每次同时包含相似度和 AI 报告。