Turnitin AI 偵測到底怎麼運作?逐句評分與星號門檻
Turnitin 不會為你的整份報告算出一個「AI 機率」。它把文字切成段落,逐句評估統計模式有多像模型輸出——也就是 Turnitin 公開說明過的困惑度(perplexity)與節奏變化(burstiness)這類概念——報告頂端的 AI 寫作百分比,就是被標記文字的比例。低於大約 20% 時,正式報告會顯示星號(*)而不是確切數字。以下內容全部依據 Turnitin 自己的公開文件;截圖來自我們測試文章跑出的真實報告,不是任何學生的繳交件。
關於作者身分。我們是從報告的另一頭寫這篇的:InDetect 是第三方提交前檢查服務,透過獲授權的教師層級 Turnitin 帳號跑文章。看過幾百份真實報告,讓我們能準確描述這些機制——但我們不是 Turnitin,他們內部模型的事,我們只講他們公開的部分。
重點整理
評分發生在句子層級;最上面那個百分比只是你的文字被標記的比例。
偵測器讀的是統計上的平順度——可預測的用詞、均勻的節奏——不是你的想法「聽起來像不像 AI」。
大約 20% 以下會看到星號而不是數字;灰色破折號代表文章根本沒被處理。
Turnitin 自己都把輸出稱作訊號、不是判決——而且因為基率問題,再好的偵測器也會誤標人類寫作。
想看到自己的句子到底怎麼被標記,唯一的方法是繳交前跑一次真實引擎。
1. 只有 30 秒的話,看這裡
三句話講完。Turnitin 的 AI 寫作偵測器把你的報告切成段落,逐段標為「很可能 AI 生成」「很可能人類寫作」或「兩者混合」。報告頂端的百分比,是被分析文字裡被標記的比例。如果這個比例低於大約 20%,Turnitin 會藏起確切數字,改顯示星號。
再加一句,因為它很重要:Turnitin 自己的指引把這個分數描述為給老師追查用的指標,不是違規認定。30% 的報告不代表你 30% 的內容是假的,只代表 30% 的句子在分類器眼裡統計上太平順。
2. 不帶數學的困惑度與節奏變化
Turnitin 用兩個統計概念公開解釋過 AI 偵測。你不需要會算,只要懂直覺。
困惑度(perplexity)粗淺地說,就是語言模型覺得下一個字有多令人意外。模型寫出來的文字,多半由模型自己最偏好的用詞組成——平順、可預測、低困惑度。人類會亂走:奇怪的詞搭配、沒預料到的轉折、一個統計上沒人都會挑的怪形容詞。
節奏變化(burstiness)是句子長度與結構的波動程度。人類寫作是一陣一陣的——一個迂迴的長句,接著三個字,再來又一個長句。模型沒人管的話,會滑進長短一致、開頭雷同的均勻節奏。
這兩種特性都不是鐵律。很多仔細寫的人類文字就是平順又均勻——學術寫作尤其如此。這正是誤判存在的原因,也是第 6 節重要的原因。
3. Turnitin 怎麼逐句評分
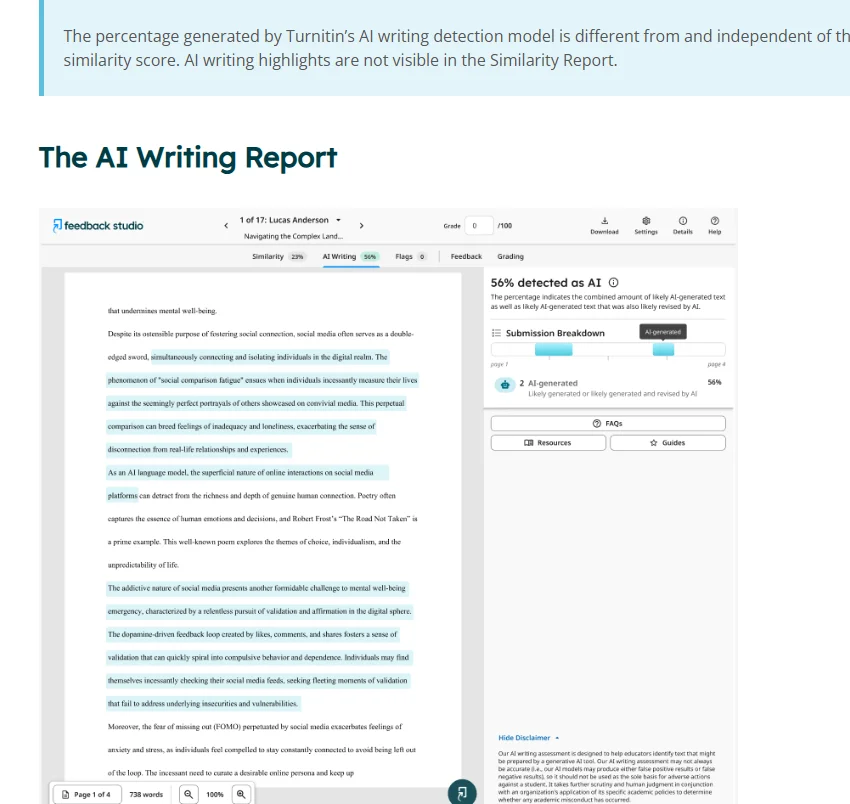
這是學生最常誤解的部分。AI 寫作報告不是蓋在你文件上的單一判決。打開一份,會看到文字按段落標色:標為「很可能 AI 生成」的段落,和標為「可能混合」的段落——一部分人類、一部分機器。文件內文的顏色對應分數面板裡的類別,跟 Turnitin 官方幫助文件描述的一模一樣。
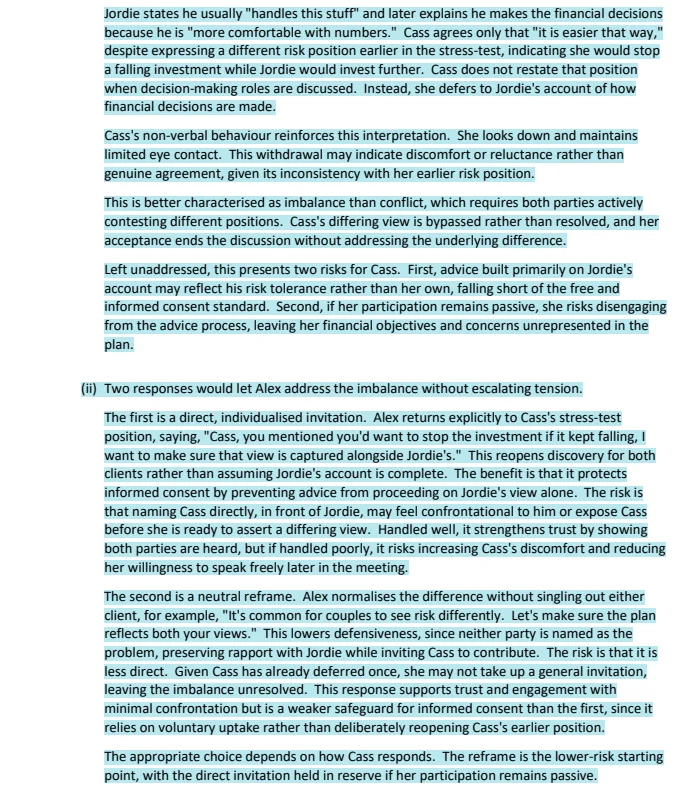
最上面的百分比就是從這些被標記段落算出來的:粗淺說,是分類器不認為完全出自人類的句子比例。這也解釋了為什麼完全自己寫的文章仍可能出現非零分數——幾個恰好讀起來平順的句子被標記,其餘不會。
同樣的道理,改一段就能讓數字明顯變動。分數是逐段決定的加總,不是你整份文件的固有屬性。
4. 為什麼你看到的是星號而不是數字
AI 寫作面板有三種狀態,學生老是把它們搞混。
0% 代表文章被分析了、什麼都沒被標記。以偵測器的狹義標準來說,是乾淨的。
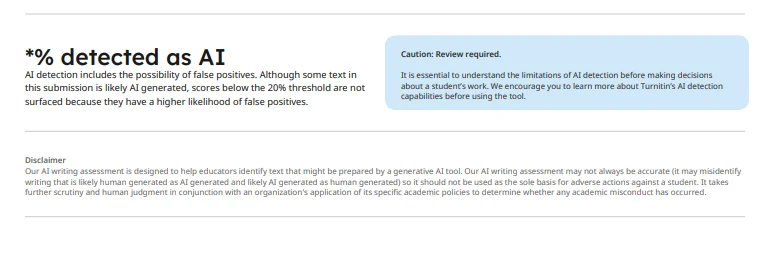
*%(星號)代表文章被分析了,被標記的比例非零但低於門檻——大約 20%——低到 Turnitin 認為這個訊號不可靠、不適合顯示成確切數字。那不是藏起來的指控;是公司在對老師說:「夠低了,別據此行動。」星號的完整說明在我們這篇星號分數代表什麼。
灰色破折號代表文字完全沒被處理——通常是因為太短,或連續散文太少,偵測器無從分析。它不是零分,也不是你出了錯。
5. Turnitin 不做的事
傳聞比事實更離譜。根據 Turnitin 公布的內容,值得把話說清楚:
它不讀檔案中繼資料——Word 的作者欄、建立時間戳記——來判斷文字是不是 AI。
它偵測不出你的*想法*是不是下 prompt 生成的。它分析的是用詞模式,不是想法的來源。
它不會從 ChatGPT 或任何模型收到浮水印訊號。面向消費者的 chatbot 沒有嵌入可偵測的標記,Turnitin 也沒有來自 OpenAI 的內線。
它不會對整份文件跑一個是/否分類器。如前所述,決定是一段一段做的。
Turnitin 對這一切的自家措辭是「訊號,非判決」。這個數字是讓人類開始調查的起點,不是終點。
6. 基率謬誤:為什麼再好的偵測器也會誤判
這是一堂沒人來得及在你被指控之前教你的統計課。
假設一個偵測器會誤標 100 份人類文章裡的 1 份。聽起來很棒。再假設 1,000 份繳交裡有 900 份真的是人類寫的。那 1% 的錯誤仍會標到 9 份人類文章。如果只有 100 份是 AI 寫的、偵測器抓到其中 80 份,那麼被標記的 89 份裡有 9 份是無辜的——大約每 10 次標記就有 1 次是誤標。
這不能怪偵測器的數學。只是人類寫作遠比 AI 寫作常見,所以哪怕錯誤率再低,乘以龐大的人類樣本,也會產生可觀的誤標數量。這就是基率謬誤,也是為什麼被標記的句子只是可翻案的證據,不是證明。
如果你哪天被誤標:你的草稿、版本歷史、大綱,還有你向教授說明這篇文章怎麼寫的能力,都比任何分數值錢。
7. 在自己的文章上看到同樣的評分
你沒辦法憑空推想自己的 AI 分數。你需要在繳交之前、在教授將會看到的那份真實報告裡,看到到底是*你的*哪些句子被標色。
InDetect 做的就是這件事:你的文章透過設定為零資料庫存放的獲授權教師帳號,跑真實的 Turnitin 引擎,5 到 30 分鐘拿到完整的相似度+AI 報告。文章與報告 24 小時內刪除。我們不保留任何資料庫,你的預覽永遠不可能在你繳交時比對到自己。實際流程見我們的服務逐步實測評測,跟其他選項的比較見 Turnitin 檢查工具完整指南。我們也拿模型生成的文字跑過引擎,結果在 Gemini、ChatGPT、Claude 偵測實測。
8. FAQ:Turnitin AI 偵測怎麼運作
Turnitin 是檢查整篇文章,還是逐句檢查? 它把文字切成段落逐一標記。頂端的 AI 寫作百分比是被分析文字中被標記的比例,所以文件層級的數字是逐句決定的加總。
AI 報告裡的黃色和紫色標記是什麼意思? 依 Turnitin 官方報告圖例,它們區分完全被標記的段落(很可能 AI 生成)與部分被標記的段落(可能是人類與 AI 混合)。內文的顏色對應分數面板的類別。
為什麼我的 Turnitin AI 分數顯示星號而不是數字? 因為被標記的比例低於約 20% 的門檻——在那之下,Turnitin 認為確切數字沒有意義。星號代表低但非零的結果,不是隱藏的懲罰。
Turnitin 會誤判人類寫的文字嗎? 會。人類文章遠多於 AI 文章,所以即使誤標率低,仍會產生實質數量的無辜學生被標。Turnitin 自己也把分數定位為供調查的訊號,不是判決。
排版或文法工具會改變 AI 分數嗎? 排版本身不會。編輯會——因為分數來自句子層級的統計模式,用激進的改寫工具把你的文字磨平,會改變哪些句子被標記。
9. 結論:它是句子分類器,不是讀心術
Turnitin 的 AI 偵測逐段評分、彙整成百分比、在約 20% 以下藏起數字、拒絕處理太短的文字。它讀的是統計紋理,不是意圖;而且因為基率問題,連做得好的分類器都會誤判人類寫作。
如果你想知道自己的句子會被怎麼標記,繳交前把真實引擎跑一次。InDetect 符合資格的新用戶可免費檢查一次(能不能用取決於你所在的國家),或 Lite $9/月含 2 次(每篇文章 $4.50),報告 5 到 30 分鐘送達。