提交前查 Turnitin 相似度分数:怎么查不入库
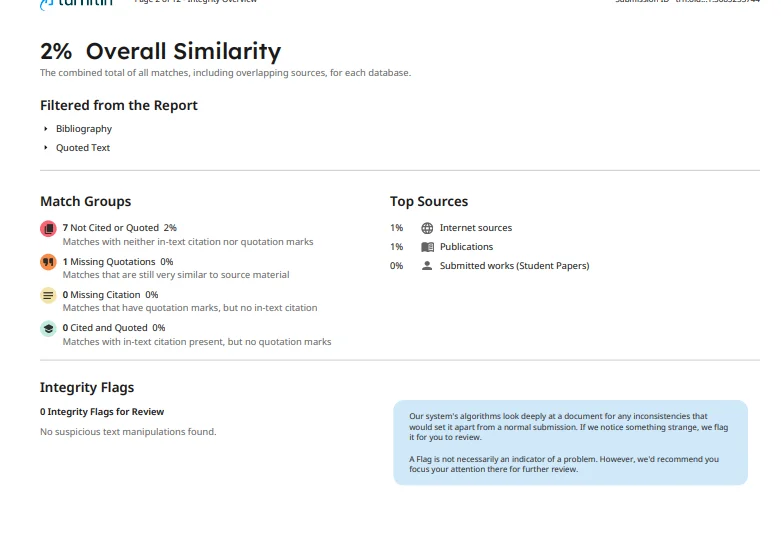
可以——你在提交之前就能看到和老师看到的完全一样的相似度报告。关键不在时间点,而在存储:检测必须在不把论文加入 Turnitin 学生论文库的前提下运行。至于数字本身,多数老师把 15–25% 以下视为正常,一篇引用规范的论文高于这个区间也完全合理。目标不是 0%——是搞清楚每一处匹配到底是什么。开始前再说一句:相似度和 AI 写作是报告上两个独立的数字,这篇讲的是第一个。
关于作者身份。先把话说透:这篇来自 InDetect,一家第三方提交前检测服务,和 Turnitin 没有隶属关系。我们把你上传的文件通过配置为零入库的授权教师账号来跑,文中所有截图都出自我们自己的测试论文——不含任何真实学生数据。这篇文章描述的检测就是我们卖的,读的时候请带着这一点。
核心要点
提交前查相似度是可行的;要紧的是存储设置,不是时间点。
常规课程提交会进入 Student Paper Repository,之后可能"和自己匹配"。No Repository 模式不会。
15–25% 是常见的教师容忍区间,不是官方规则。即使总分很低,单一来源超过约 3% 也值得看一眼。
相似度不是抄袭,也不是 AI 分数——三个不同的数字,三种不同的修法。
粘贴框式的"Turnitin 检测器"查不了 Turnitin 的数据库。只有真实引擎才能产出真实相似度报告。
1. 相似度分数到底在测什么
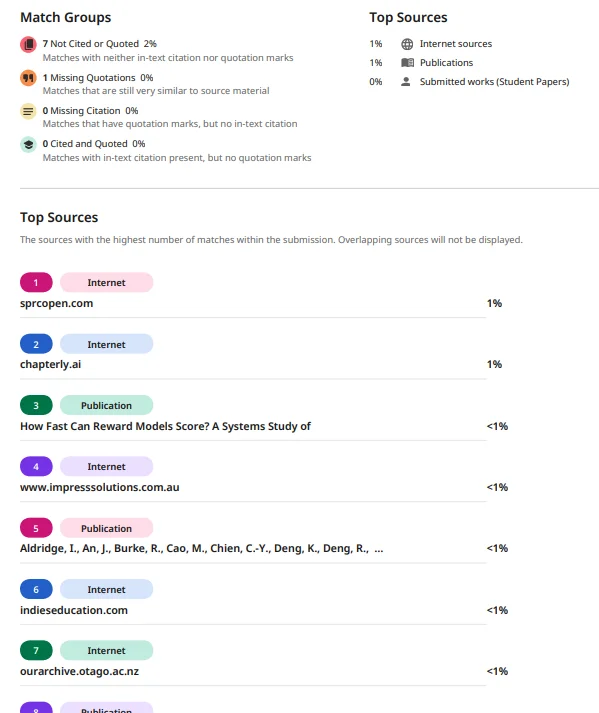
Turnitin 把你论文里提取出的文本和三类东西比对:数十亿已收录和已归档的网页、授权学术与出版物内容,以及它存档的学生论文库。每一处匹配都会生成一条来源记录和一个百分比。
页首那个大数字,是你的文字和这些数据库里内容重叠的比例——按你老师的设置计算之后的比例。最后这半句比学生以为的更重要。exclude quotes(排除引文)和 exclude bibliography(排除参考文献)两个开关,加上 small-match filter(小匹配过滤,常设为 1 个词或 1%),都会在不改动你论文的情况下改变分数。一位老师设置下的 22%,换到另一位老师的设置里可能显示 12%。
所以这个百分比不是你写作本身的属性,而是你的写作加上设置的属性。提交前先查时,你要的是用贴近真实的设置生成的报告,而且首先必须零入库——第 4、5 节讲为什么。
2. 相似度分数与 AI 分数:两个数字,各干各的
新版 Turnitin 报告上有两个分数,学生经常把它们搞混。
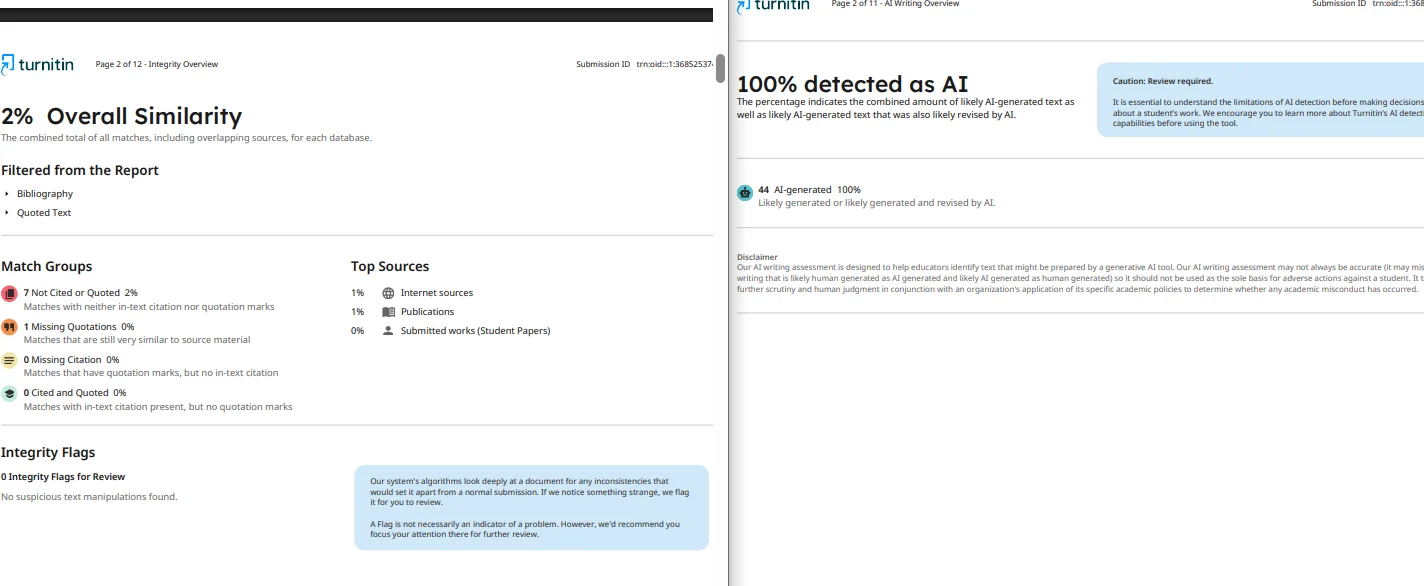
相似度问的是:*这段文字和已有文字重叠吗?* AI 写作面板问的是:*这段读起来像大模型生成的吗?* 一篇完全原创的论文照样可能 AI 分数很高——正式、节奏均匀的文风就会这样。一篇抄来的论文也可能 AI 分数很低——检测器不关心文字从哪来,只关心它怎么写的。
两个数字并排放在同一份报告里,却各自独立变化。修引用不会让 AI 百分比动一下,改文风节奏也不会让相似度动一下。想要逐面板的讲解——包括 AI 分数为什么有时显示成 *% 而不是数字——读我们的Turnitin AI 报告怎么看。
3. 多少相似度百分比算可接受?
不存在官方安全线——Turnitin 没发布过,每位老师自己划。从各大学公开表述和老师们的反馈看,实际区间大致是:
15% 以下: 很少被质疑。
15–25%: 多数老师视为正常,引用规范时尤其如此。
25% 以上: 会引来对来源列表的审视——但不是自动指控。
任何单一来源超过约 3%: 即使总分很低也值得复查,因为一处集中的匹配和四十处零散的匹配是完全不同的问题。
长引文、文献综述、用标准表述的方法章节,都会合理地推高数字。正确的姿态不是往 0% 挤压——是每一处超过百分之几的匹配你都能解释清楚。去查你的教学大纲和学校的政策,它们比任何网络经验法则都管用,包括我们这条。
4. "先查一遍,我的论文会出现在 Turnitin 里吗?"
这个顾虑让很多学生干脆不预检,所以直接回答:完全取决于检测怎么跑。
向课程作业的常规提交会被存进 Student Paper Repository。一旦入库,你的论文就成为之后每份比对的数据库的一部分——包括你自己的最终提交。查错方式,你的期末论文会和自己以 100% 或接近 100% 匹配,看起来像重复提交,恰好触发你想避免的那场谈话。
用 No Repository 设置跑的检测什么都不存。很多老师给草稿检查点特意用这个设置,正规的第三方服务也是同样配置。在 InDetect,上传的文件从不进入论文库,论文和报告都会在 24 小时内删除。
诚实的警告:不是每家服务都遵守零入库设置,配置失误的一家可能把你的论文归档。往任何地方上传之前,确认服务用平实的语言(而不是埋在法务条款里)写明了零入库存储和删除时限。
5. 没有 Class ID 的学生怎么查相似度
你没法自己注册 Turnitin 账号,向课程提交又需要老师掌控的 Class ID。现实的路径有两条。
5.1 方案 A——请老师开一次练习提交
有些学校在正式截止前,用零入库设置跑草稿提交。免费,完全正规。局限也明摆着:得老师愿意开,而且时间可能比你需要的晚一周。学期初就问,别等到截止前三天。
5.2 方案 B——第三方真实引擎预检
这类服务把你上传的文件路由进零入库的授权教师账号,返回真实报告。预期 5 到 30 分钟,不是秒出——引擎要给真实提交排队,任何承诺十秒出 Turnitin 报告的都是模拟器。资格国家的新用户可免费查一次(可用性取决于你所在的国家);否则 Lite 是 $9/月 2 次($4.50 一次),每次都包含相似度和 AI 两份报告。
一个要避开的坑:粘贴框式"Turnitin 检测器",几秒给你一个数字。它们查不了 Turnitin 的数据库——跑自己的模型猜。真实的相似度报告需要真实的引擎。我们的免费 Turnitin AI 检测市场拆解教你三十秒分辨两者。
6. 拿到相似度报告后,截止日期前怎么读
报告到手,把它当检查清单用,别当判决书。
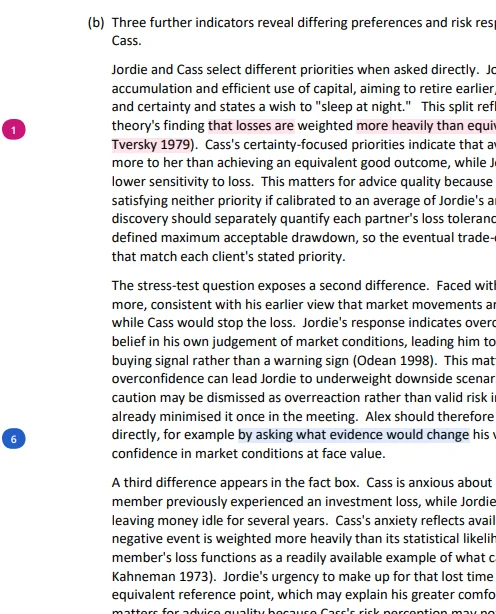
先看侧边栏的来源列表:按百分比排序的匹配。忽略页首数字的颜色,逐条读内容。四十条各占 0.5% 的网页匹配,是套话短语。你论证段落上那一条 9% 的匹配,才是要修的。
再用过滤器:把排除引文和排除参考文献打开。如果分数从 24% 掉到 11%,说明匹配来自你的引用——没关系,引文本来就该长这样。如果几乎不动,重叠就在你自己的正文里。
最后打开文档视图,结合上下文读标色部分。定义和标准术语的重叠很正常。分析部分的重叠需要改写并加引用。逐面板的完整讲解见Turnitin AI 报告怎么看;如果你担心的其实是 AI 那个数字,我们的降低 Turnitin AI 分数改写指南讲那一侧。
7. 常见问题:提交前的相似度预检
提交前我能在 Turnitin 上查自己的论文吗? 能,两条路:老师运行的零入库草稿提交,或把论文路由进授权账号跑真实 Turnitin 引擎的第三方服务。通过 Turnitin 本身自助查不了——学生没有个人账号。
先查一遍,Turnitin 会保存我的论文吗? 只有检测开着入库存储时才会。配置正确的零入库检测什么都不存,所以你的最终提交不会和自己的草稿匹配。往任何地方上传前,先确认零入库设置和删除时限。
Turnitin 的相似度百分比多少算可接受? 没有官方数字。多数老师视作业而定,把 15–25% 以下当作正常;而任何单一来源超过约 3%,无论总分多少都值得看一眼。你学校的政策比任何通用经验法则都优先。
相似度高就是抄袭吗? 不是。相似度测的是文字重叠——引文、通用术语、你自己以前的提交都会推高它。抄袭是关于署名的判断。先读来源列表,再决定要不要慌。
没有 Class ID 能拿到 Turnitin 相似度报告吗? 没法直接从 Turnitin 拿——Class ID 由老师提供。请老师开草稿位,或用真实引擎的第三方服务。避开粘贴框工具:它们访问不了 Turnitin 的数据库,它们的"相似度分数"是猜的。
8. 在老师看分数之前,自己先看
整件事的关键,是在还来得及改的时候,看到那份带真实来源列表的真实报告——同时确保检测不会归档你的论文。用零入库跑一遍,把每一处超过百分之几的匹配都读一遍,剩下解释得清的照常引用。
符合条件的新用户免费查一次(可用性取决于你所在的国家),或 Lite $9/月 2 次(每篇 $4.50)。报告 5 到 30 分钟出;论文和报告在 24 小时内删除。