如何查看 Turnitin AI 报告:每个面板详解
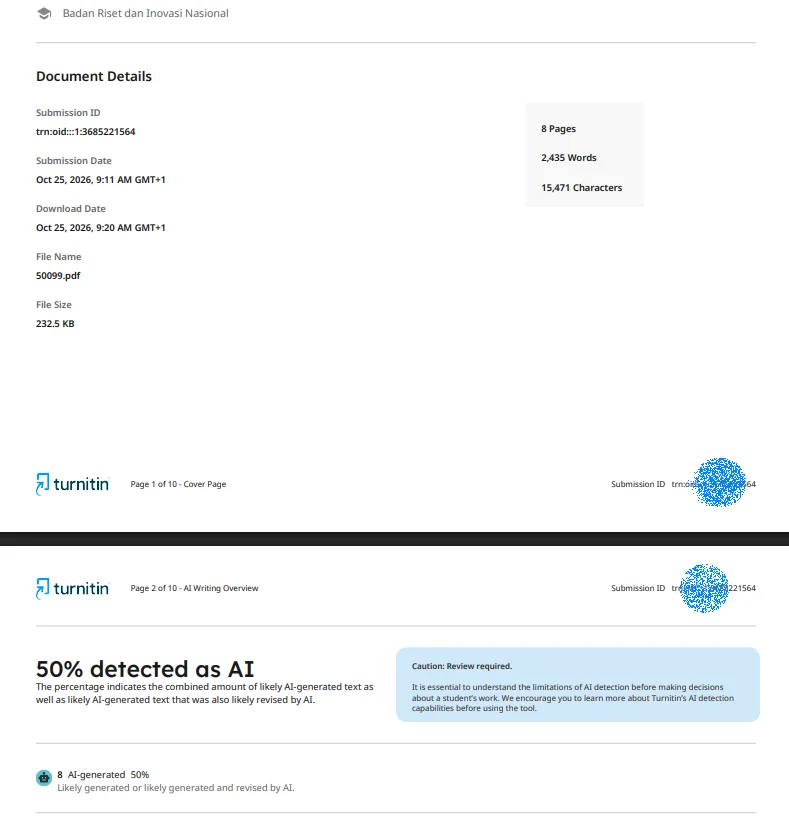
先说结论:一份 Turnitin 报告有两个互相独立的数字——相似度百分比和 AI 写作百分比——而它们的含义和多数学生的想象都不一样。AI 分数落在 1 到 19% 之间时,报告不显示数字,只显示 *%。Turnitin 披露的误差范围约 ±15 个百分点。低于有效词数门槛的文本根本不参与分析——这就是短论文或引文密集的论文出现灰色高亮或破折号的原因。本指南把真实报告的每个区域都标出来,让你不用猜也能读懂自己那份。
关于作者身份。本指南来自 InDetect 团队——我们是一家第三方提交前检测服务,通过授权教师账号运行真实的 Turnitin 引擎。我们并不中立——本文教你读的报告,正是我们卖的检测生成的。下面每张截图都来自我们自己的测试论文,不是真实学生的提交。
核心要点
相似度 % 和 AI % 是两个独立的测量,修的方法也各自不同。一个高,说明不了另一个任何事。
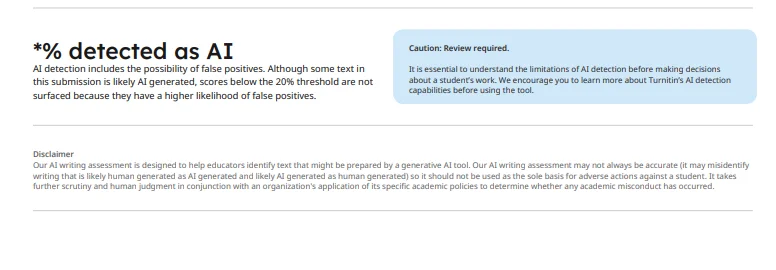
AI 分数 1 到 19% 按设计显示为 *%;灰色破折号意味着文本根本没被处理。
只有"有效词"参与 AI 分析。大约 300 词以下,数字不可信。
排除项和小匹配过滤会改变相似度数字而不动你的文本——先弄清你学校开的是哪些设置。
报告长什么样,跟谁生成它无关——教授生成的和预检服务生成的完全一样,因为是同一个引擎。
1. 报告全景图
每份 Turnitin 相似度报告都有五个区域,认全了名字,你就不用再对着颜色慌了。
页眉放提交元数据:标题、作者、提交日期、词数。相似度侧栏(通常在右侧)放总相似度百分比和按占比排序的匹配来源列表。AI 写作面板显示整篇的 AI 百分比和逐句标记。中间的文档查看区展示你的文本,两项检查的彩色高亮都在上面。工具栏提供过滤器:排除引文、排除参考文献、小匹配阈值。
第 2 到 5 节各放大讲一个区域。这里没有杜撰——这是 Turnitin 官方帮助文档描述的布局,用我们测试论文的真实报告演示。
2. 相似度侧栏:分数、来源、排除项
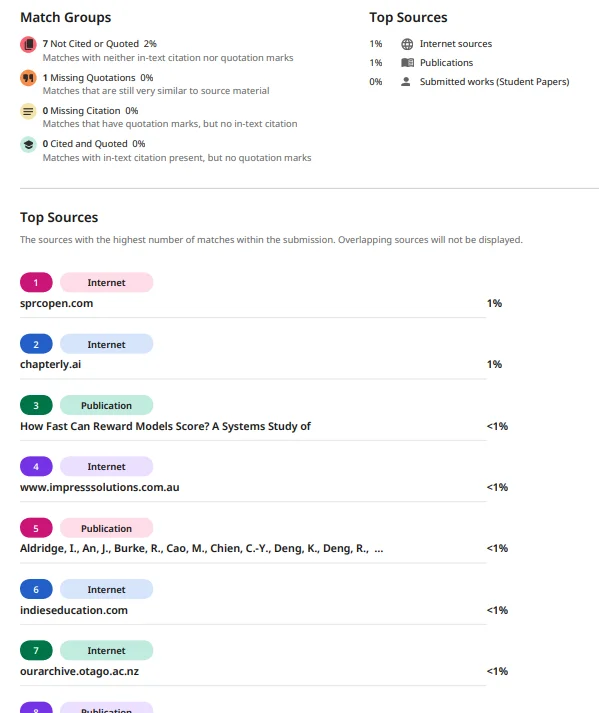
侧栏顶部的大数字,是你的文本与 Turnitin 数据库中内容匹配的比例。彩色区间(绿到红)是给教师看的惯例,不是官方定性——Turnitin 从不按颜色定义"抄袭"。
分数下面是按百分比排序的匹配来源。每一条是一个网页、一篇期刊文章或一篇学生论文。总相似度 14%,可能是两个来源各 6%,也可能是四十个来源各 0.4%——完全是两种局面,列表会告诉你属于哪一种。
有两个设置会悄悄改变数字。小匹配过滤器忽略低于阈值的匹配(教师常设为 1 词或 1%,于是零碎的短语重叠就消失了)。排除引文 / 排除参考文献开关会把匹配到的引文和文献条目从总分里剔除。同一篇论文,设置不同,数字不同——所以你在别处看到任何百分比之前,先查清你学校用的是什么设置。
3. AI 写作面板:整篇百分比 vs 句子高亮
AI 面板回答的问题和侧栏不同:不是"这段和已有文本重不重复",而是"这段读起来像不像大模型写的"。
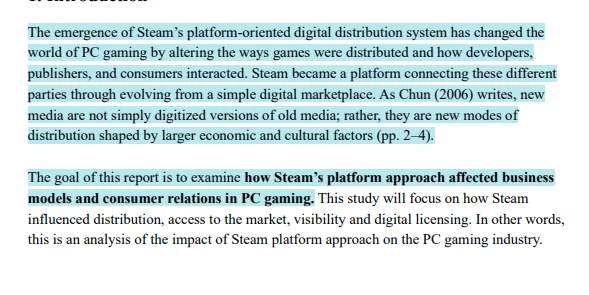
整篇百分比是模型判定"可能 AI 生成"的文本占已分析部分的比例。下面逐句标记"可能 AI 生成"或"可能包含 AI 生成内容"。这是模型官方的限定措辞——Turnitin 从不说"就是 AI 生成"。
我们见得最多的误区是:学生盯着百分比,忽略高亮。高亮才是能行动的部分。它逐句告诉你到底是哪些句子触发了模型。
你还会注意到有些文本是灰色的或没有任何标记。那不是通过——是文本没被分析:太短、属于引文,或者低于第 5 节讲的有效词数门槛。
4. *% 与破折号:被藏起来的分数和未处理的文本
有时 AI 面板显示的不是数字,而是 ***%。这不是故障,也不是惩罚。当 AI 百分比落在 1 到 19% 之间时,Turnitin 会隐藏精确数字,因为在这个低置信区间,误报率高到显示精确数字反而会误导教师。*% 的意思是"量很小,处在检测器没把握的区间"。
灰色破折号说的是另一回事:这篇文档根本没做 AI 处理。原因通常是论文太短、模型跑不了,或者教师的设置没给这个作业开 AI 检测。
星号的完整机制——包括为什么追着 20% 以下的显示数字跑是追影子——在我们的Turnitin 星号百分比专文里讲透了。
5. 什么是有效词(qualifying words)?
AI 检测器不会把页面上每个词都嚼一遍。它数的是有效词——文档里长度和连续性达到分析要求的部分。短段落、块引用、参考文献列表通常不算。
两个实际后果。第一,一条 150 词的讨论帖可能返回破折号或一个剧烈跳动的百分比——信号不够。大约 300 词起,这个面板才开始值得读。第二,一篇大量引用他人原文的长论文,即使全文 4,000 词,被分析的词数也可能很低。
报告里能看到有效词数。跟百分比较劲之前先看它:模型只分析了 200 词,这个数字就只有 200 词的置信度。
6. 相似度 vs AI:两个独立的数字,两种不同的修法
学生老把这两个混在一起,这里给个清爽版本。
相似度高意味着与已有文本重叠。修法是引注功夫:规范引用、真正改写、检查参考文献是不是意外匹配上了。我们的提交前相似度检测指南讲了教师实际会把哪些百分比视为正常。
AI 高意味着检测器认为你的文字在统计上像模型产物。如果是你自己写的,那是误报,修法是节奏和具体化——技巧在我们如何降低 Turnitin AI 分数的指南里。
一篇论文可以 5% 相似、60% 被标 AI,也可以 40% 相似、显示 *%。两个数字不相关,修一个不动另一个。还有,两者都要记住 Turnitin 自己披露的 ±15 个百分点误差:读高亮,别只读首页数字。
7. 常见问题:读懂 Turnitin 报告
我该怎么查自己的 Turnitin AI 报告? 学生没有 Turnitin 直接入口——报告由订阅机构里的教师账号生成。请老师分享报告,或者用跑真实引擎的预检服务。无论哪种,布局都一样:相似度侧栏、AI 写作面板、文档查看区。
Turnitin 的相似度和 AI 分数有什么区别? 相似度衡量与已有来源的文本重叠。AI 分数衡量已分析文本中模型判定"可能机器生成"的比例。两者互相独立:原创的人类写作可能在 AI 面板拿高分,抄来的文本可能拿低分。
为什么我的 Turnitin AI 分数显示 *% 而不是数字? 因为分数落在 1 到 19% 之间。在这个区间,误报率让小数字不可靠,Turnitin 就隐藏精确值。*% 通常正是你想要的区间。
报告里多少比例算有效词? 没有固定比例——有效词取决于文档长度和结构。短段落、引文、参考文献列表被排除。大约 300 词以下的论文常常根本无法分析。
一篇论文的 Turnitin AI 百分比多少算好? Turnitin 不公布及格线,各校有自己的预期。考虑到披露的 ±15 个百分点误差,任何单次读数都只能当近似值,重点看哪些句子被标记了。
8. 然后呢:分别处理两个数字
没有报告,就没法行动。如果学校不在截止日期前分享报告,就自己拿一份:InDetect 5 到 30 分钟交付真实的 Turnitin 报告——两个数字、所有面板——零入库,24 小时内删除。符合条件国家的新用户免费一次(可用性取决于所在国家);Lite $9/月 2 次($4.50 一次)。不确定哪些服务真的跑真实引擎?我们的Turnitin 检测工具指南帮你分类。然后对照本文,一个面板一个面板地读你的报告。