TurnitinのAI検知は実際どう動く?仕組みをわかりやすく解説
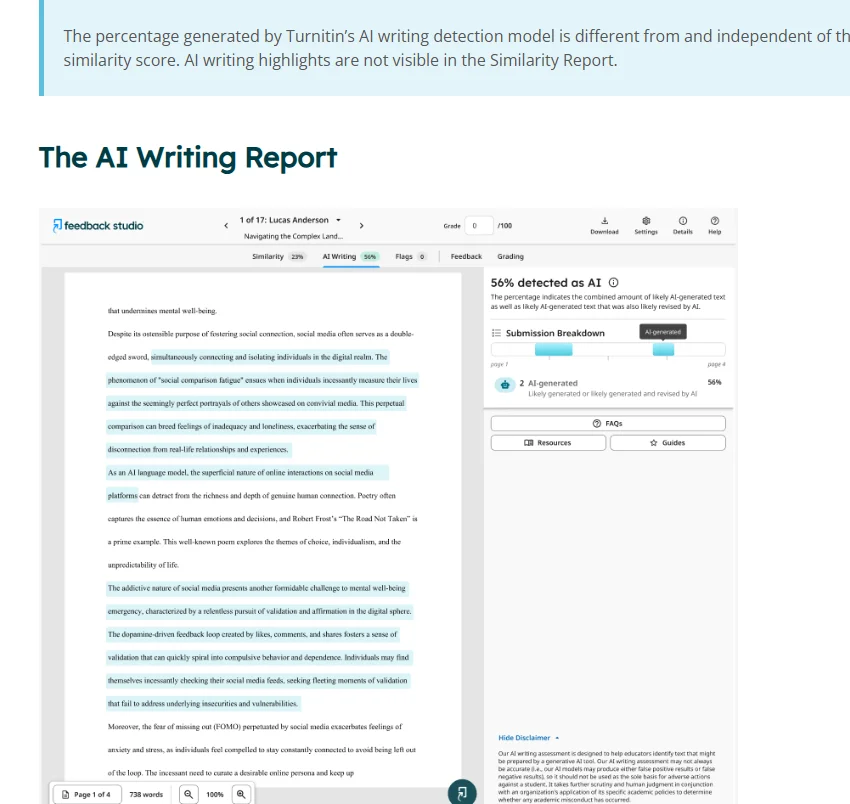
Turnitinはレポート全体に対してひとつの「AI確率」を計算しているのではありません。文章を区切りに分けて、文ごとに「モデルが書きそうな統計パターンにどれだけ似ているか」を採点しています。Turnitin自身が公開している説明では、perplexity(次の語の予測しにくさ)やburstiness(文のリズムのばらつき)といった考え方に基づいています。レポートの冒頭に表示されるAI Writingのパーセンテージは、フラグが立った文章の割合です。20%を下回ると、公式レポートには正確な数字の代わりにアスタリスク(*)が表示されます。ここからの説明はすべてTurnitinの公開ドキュメントに基づくもので、スクリーンショットは当サイトのテスト用レポートで実際に生成されたものです。誰かが提出したレポートではありません。
執筆者について。私たちはレポートの「もう一方の側」からこの文章を書いています。InDetectは、講師権限を持つ正規のTurnitinアカウントでレポートをチェックする、提出前のサードパーティーツールです。数百もの実際のレポートを見てきたからこそ、仕組みを正確に説明できます。ただし私たちはTurnitinではなく、公開されている情報以上の内部モデルの知識を持っているとは主張しません。
要点まとめ
採点は文単位で行われます。冒頭のパーセンテージは、フラグが立った文章の割合にすぎません。
検知器が見ているのは統計的な「滑らかさ」です。予測しやすい語選びや均一なリズムであって、あなたのアイデアが「AIっぽく聞こえるか」ではありません。
20%前後を下回ると数字の代わりにアスタリスクが表示されます。灰色のダッシュは、そもそも解析されなかったことを意味します。
Turnitin自身、出力は判定ではなく「シグナル」だと呼んでいます。優秀な検知器でも、ベースレートのせいで人間が書いた文章を誤検知することがあります。
自分の文がどうフラグされるかを確認する唯一の方法は、提出前に実際のエンジンで走らせることです。
1. 30秒だけ時間をもらえるなら
3文でまとめます。TurnitinのAI執筆検知はレポートを区切りに分けて解析し、それぞれ「AIが書いた可能性が高い」「人間が書いた可能性が高い」「混在」のいずれかと判定します。レポート冒頭のパーセンテージは、解析された文章のうちフラグが立った割合です。その割合が20%前後を下回ると、Turnitinは正確な数字を隠してアスタリスクを表示します。
もう1文だけ足します。ここが大事だからです。Turnitin自身のガイドでも、スコアは不正の認定ではなく、講師が調査を始めるための指標だと説明されています。「30%のレポート=あなたの作業の30%が偽物」という意味ではありません。分類器に対して、あなたの文の30%が統計的に滑らかすぎると映っただけです。
2. perplexityとburstinessを、数式なしで説明する
TurnitinはAI検知について、2つの統計的な考え方で公開説明しています。数式は不要です。直感だけつかめば十分です。
perplexityは、ざっくり言えば「言語モデルにとって次の語がどれだけ意外か」です。モデルが書いた文章は、モデル自身が最も選びそうな語の連続になりがちで、滑らかで、予測しやすく、perplexityは低くなります。人間は遠回りします。妙なコロケーション、意外なつなぎ、統計的に誰も選ばないような変な形容詞が出てきます。
burstinessは、文の長さや構造がどれだけばらつくかです。人間は「かたまり」で書きます。長くうねるような一文のあとに、3語だけの文。また長い文。一方、モデルは放っておくと、同じような始まりの中等度の文が均一なリズムで並びます。
どちらも法則ではありません。丁寧に書いた人間の文章は滑らかで均一になりがちで、学術文章は特にそうです。だからこそ誤検知が生まれるわけで、6章が重要になります。
3. Turnitinは文ごとにどう採点するのか
学生さんが最も誤解しやすい部分です。AI Writingレポートは、文書に押される一つの判定スタンプではありません。開くと、文章が区切りにハイライトされているのが見えます。「AIが書いた可能性が高い」とマークされた箇所と、「人間と機械の混在の可能性がある」とマークされた箇所です。本文の色はスコアパネルの内容とそのまま対応しています。これはTurnitinの公式ヘルプドキュメントの説明どおりです。
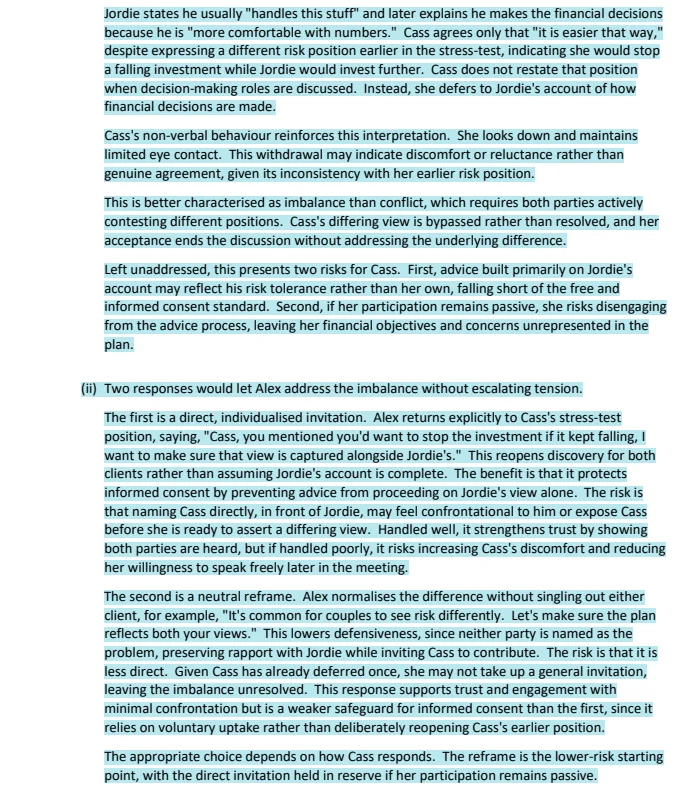
冒頭のパーセンテージはこのフラグ付き区切りから算出されます。ざっくり言えば、分類器が「完全に人間が書いた」と見なさなかった文の割合です。だから自分で全部書いたレポートでも0にならないことがあります。たまたま滑らかに読める文がいくつかフラグされ、残りはされないからです。
1段落を直すと数字が目に見えて動くのも同じ理由です。スコアは局所的な判断の集計であって、文書全体の属性ではありません。
4. 数字の代わりに「*」が出る理由
AI Writingパネルには3つの状態があり、学生さんはいつも混同します。
0%は、解析された上で何もフラグが立らなかったことを意味します。検知器の狭い意味での「クリーン」です。
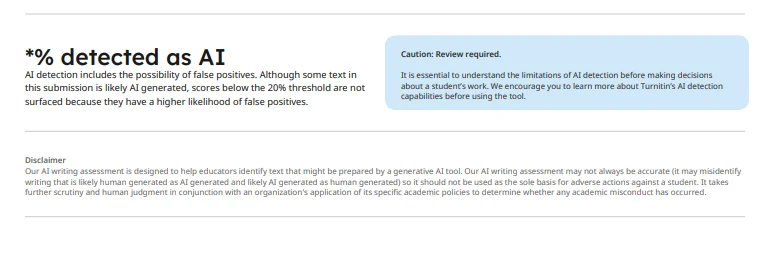
*%(アスタリスク)は、解析された上で、フラグの割合が0ではないもののしきい値(20%前後)を下回っていることを意味します。Turnitinはそこを、シグナルとして信頼性が低く正確な数字では表示できない領域と考えています。隠れた告発ではありません。「十分低いので、対応しないほうがよい」と会社側が講師に伝えている表示です。アスタリスクについてはアスタリスクの意味を解説した記事で詳しく扱っています。
灰色のダッシュは、その文章がそもそも解析されなかったことを意味します。たいていは、長さが短すぎるか、連続した散文が少なすぎて検知器が解析できない場合です。0点ではなく、あなたのミスでもありません。
5. Turnitinが「やっていない」こと
噂は実態より悪いです。Turnitinが公開している情報に基づいて、はっきり書いておきます。
ファイルのメタデータ(Wordの作成者フィールドや作成日時)を読んで、AI執筆かどうかを判断することはしていません。
あなたの*アイデア*がプロンプト由来かどうかを検知することはしていません。解析するのは語のパターンであって、思考の出どころではありません。
ChatGPTや他のモデルからウォーターマーク信号を受け取ることはしていません。一般向けチャットボットに検知可能なタグは埋め込まれておらず、TurnitinにOpenAIからの秘密の回線があるわけでもありません。
文書全体を一つのYes/No分類器にかける、ということはしていません。前述のとおり、判断は区切りごとに行われます。
このすべてに対するTurnitin自身の言い方は「signal, not verdict(判定ではなくシグナル)」です。数字は人間の調査の始まりであって、終わりではありません。
6. ベースレートの誤謬:優秀な検知器でも誤爆する理由
誰にも教わらないまま、冤罪のきっかけになる統計の話をします。
ある検知器が、人間が書いたレポートを100本に1本、誤ってフラグするとします。優秀に聞こえますね。次に、提出された1000本のうち900本が本当に人間によるものだとします。誤り率1%でも、9本の人間のレポートがフラグされます。AIが書いたレポートが100本あって検知器がその80本を捉えるなら、フラグされた89本のうち9本は無実です。つまりフラグの約10本に1本は誤りになります。
この計算上の問題は検知器の責任ではありません。人間の文章はAIの文章よりはるかに多いので、誤り率がどんなに小さくても、人間の巨大な母数にかかれば無視できない数の誤検知が出ます。これがベースレートの誤謬で、フラグされた文が決定的な証明ではなく、覆せる証拠にすぎない理由です。
もし誤検知されたら:下書き、バージョン履歴、アウトライン、そして「どうやって書いたか」を教授に説明できること。どれも、どんなスコアよりも価値があります。
7. 自分のレポートで同じ採点を確認するには
AIスコアは、抽象的な理屈ではどうにもなりません。教授が目にする実際のレポートで、提出前に、*自分の*どの文がハイライトされるかを確認する必要があります。
それをやっているのがInDetectです。レポートはゼロリポジトリ保存に設定された正規の講師アカウント経由で処理され、実際のTurnitinエンジンにかけられ、類似度+AIの完全なレポートが5〜30分で届きます。レポートも結果も24時間以内に削除されます。データベースは残さないため、あなたのプレビューが提出時と食い違うことはありません。実際の流れはサービス徹底レビューで、他のツールとの比較はTurnitinチェックツール完全ガイドで確認できます。モデルが書いた文章を実エンジンで検証したGemini vs ChatGPT vs Claude 検知テストもあります。
8. FAQ:TurnitinのAI検知の仕組み
Turnitinはレポート全体を見るのですか、文ごとに見るのですか? 文章を区切りに分けて解析し、一つずつフラグを立てます。冒頭のAI Writingパーセンテージは、解析された文章のうちフラグが立った割合なので、文書レベルの数字は文単位の判断の集計です。
AIレポートの黄色と紫のハイライトは何を意味しますか? Turnitinの公式レポートの凡例によると、完全にフラグされた箇所(AIが書いた可能性が高い)と、部分的にフラグされた箇所(人間とAIの混在の可能性)を区別する色です。本文の色はスコアパネルのカテゴリと対応しています。
TurnitinのAIスコアが数字ではなくアスタリスクになるのはなぜですか? フラグの割合が、正確な数字に意味があるとしきい値(20%前後)を下回っているからです。アスタリスクは「低いがゼロではない」結果を意味し、隠れた減点ではありません。
Turnitinは人間が書いた文章を誤判定しますか? します。人間のレポートはAIが書いたレポートよりはるかに多いので、誤検知率が低くても誤ってフラグされる学生は実際に出ます。Turnitin自身が、スコアは調査のシグナルであり判定ではないと説明しています。
整形や文法ツールでAIスコアは変わりますか? 整形そのものは変わりません。編集は変わり得ます。スコアは文単位の統計パターンから出るため、書き換え力の強いツールで文章を滑らかにすると、フラグされる文が変わることがあります。
9. まとめ:Turnitinは「文の分類器」であって「心を読む機械」ではない
TurnitinのAI検知は、区切りを採点し、パーセンテージに集計し、20%前後を下回る数字は隠し、短すぎる文章はそもそも解析しません。見ているのは統計的な質感であって意図ではありません。よく出来た分類器でも、ベースレートのせいで人間の文章を誤爆します。
自分の文がどうフラグされるか知りたければ、提出前に実際のエンジンを1回かけましょう。InDetectなら、条件を満たす新規ユーザーは1回無料でチェックできます(利用可否はお住まいの国によります)。Liteは月額$9で2回チェック(1本あたり$4.50)、レポートは5〜30分で届きます。