Wie funktioniert die Turnitin-KI-Erkennung wirklich?
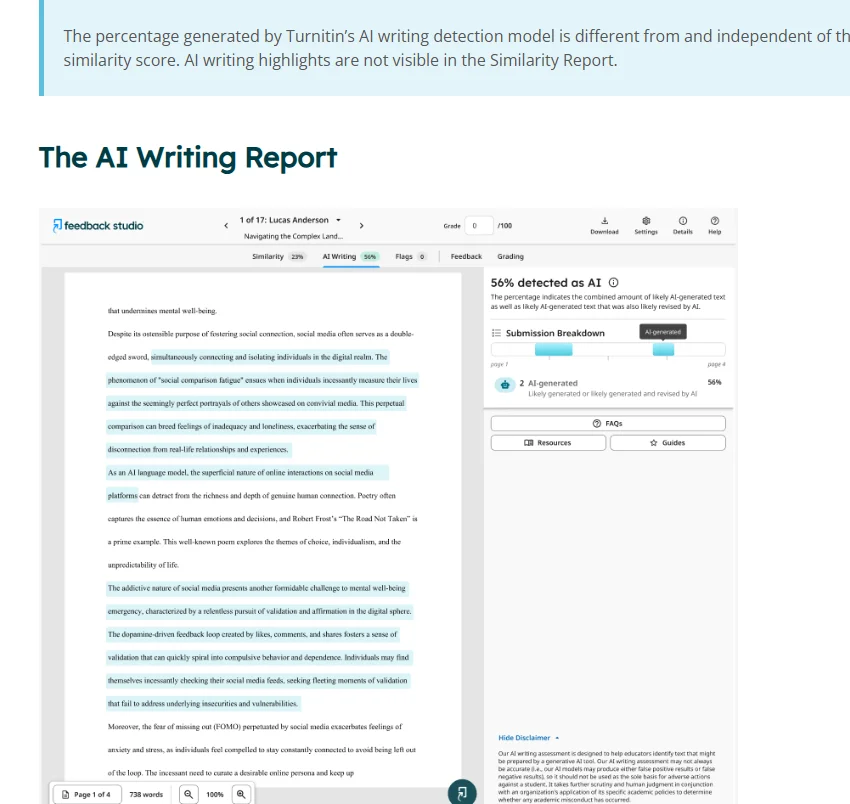
Turnitin berechnet für deine ganze Arbeit keine einzelne "KI-Wahrscheinlichkeit". Das System zerlegt den Text in Segmente und bewertet jeden Satz danach, wie modelltypisch seine statistischen Muster sind – Signale dieser Art beschreibt Turnitin öffentlich mit Konzepten wie Perplexität und Burstiness. Der Prozentsatz für "AI Writing" oben im Report ist schlicht der Anteil des markierten Textes. Unterhalb von etwa 20 % zeigt der offizielle Report statt einer genauen Zahl ein Sternchen (*). Alles Folgende basiert auf Turnitins eigener öffentlicher Dokumentation; die Screenshots stammen von echten Reports auf unseren Testpapieren – nicht von eingereichten Arbeiten.
Hinweis zur Autorschaft. Wir schreiben das von der anderen Seite des Reports: InDetect ist ein unabhängiger Vorab-Checker, der Arbeiten über autorisierte Dozentenkonten von Turnitin laufen lässt. Wir sehen hunderte echte Reports und können die Mechanik deshalb genau beschreiben – aber wir sind nicht Turnitin und behaupten kein Wissen über deren internes Modell, das über das Veröffentlichte hinausgeht.
Das Wichtigste in Kürze
Bewertet wird auf Satzebene; die Prozentzahl oben ist nur der markierte Anteil deines Textes.
Der Detektor liest statistische Glätte – vorhersehbare Wortwahl und gleichmäßiger Rhythmus –, nicht, ob deine Ideen "nach KI klingen".
Unter etwa 20 % siehst du ein Sternchen statt einer Zahl; ein grauer Gedankenstrich heißt, dass die Arbeit gar nicht verarbeitet wurde.
Turnitin selbst nennt das Ergebnis ein Signal, kein Urteil – und selbst gute Detektoren täuschen sich bei Menschtext, weil es an den Base Rates liegt.
Wie deine eigenen Sätze markiert werden, siehst du nur, wenn du die echte Engine vor der Abgabe laufen lässt.
1. Die Kurzfassung, falls du nur 30 Sekunden hast
Drei Sätze. Turnitins KI-Erkennung analysiert deine Arbeit in Segmenten und stuft jedes Teil als wahrscheinlich KI-generiert, wahrscheinlich menschlich oder als Mischung ein. Die Prozentzahl oben im Report ist der Anteil des analysierten Textes, der markiert wurde. Fällt dieser Anteil unter etwa 20 %, versteckt Turnitin die genaue Zahl und zeigt stattdessen ein Sternchen.
Noch ein Satz, weil er wichtig ist: Turnitins eigene Hinweise beschreiben den Score als Indikator, dem Dozenten nachgehen sollen – nicht als Feststellung eines Fehlverhaltens. Ein Report mit 30 % heißt nicht, dass 30 % deiner Arbeit fake sind. Er heißt, dass 30 % deiner Sätze einem Klassifikator statistisch glatt vorkamen.
2. Perplexität und Burstiness – ohne Mathe erklärt
Turnitin erklärt KI-Erkennung öffentlich anhand zweier statistischer Konzepte. Die Mathe brauchst du nicht, nur die Intuition.
Perplexität ist grob gesagt, wie überraschend das nächste Wort für ein Sprachmodell ist. Text, den ein Modell geschrieben hat, besteht meist aus dessen eigenen wahrscheinlichsten Wortwahlen – glatt, vorhersehbar, niedrig-perplex. Menschen schweifen ab: schräge Kollokationen, unerwartete Übergänge, ein seltsames Adjektiv, nach dem statistisch niemand greifen würde.
Burstiness beschreibt, wie stark Satzlängen und Satzstrukturen variieren. Menschen schreiben in Schüben – ein langer, verschachtelter Nebensatz, dann drei Wörter. Dann wieder ein langer. Modelle verfallen, sich selbst überlassen, in einen gleichmäßigen Takt mittellanger Sätze mit denselben Anfängen.
Beides sind keine Naturgesetze. Viel sorgfältiger Menschtext ist glatt und gleichmäßig – Fachprosa besonders. Genau deshalb existieren False Positives, und deshalb zählt Abschnitt 6.
3. Wie Turnitin Satz für Satz bewertet
Hier liegen Studierende am häufigsten falsch. Der AI-Writing-Report ist kein einzelnes Urteil, das über dein Dokument gestempelt wird. Öffnest du einen, siehst du einen in Segmente hervorgehobenen Text: Passagen, die als wahrscheinlich KI-generiert gelten, und Passagen, die als möglicherweise gemischt gelten – teilweise Mensch, teilweise Maschine. Die Farben im Dokumenttext entsprechen genau dem, was im Bewertungspanel steht, so wie es Turnitins offizielle Hilfedokumentation beschreibt.
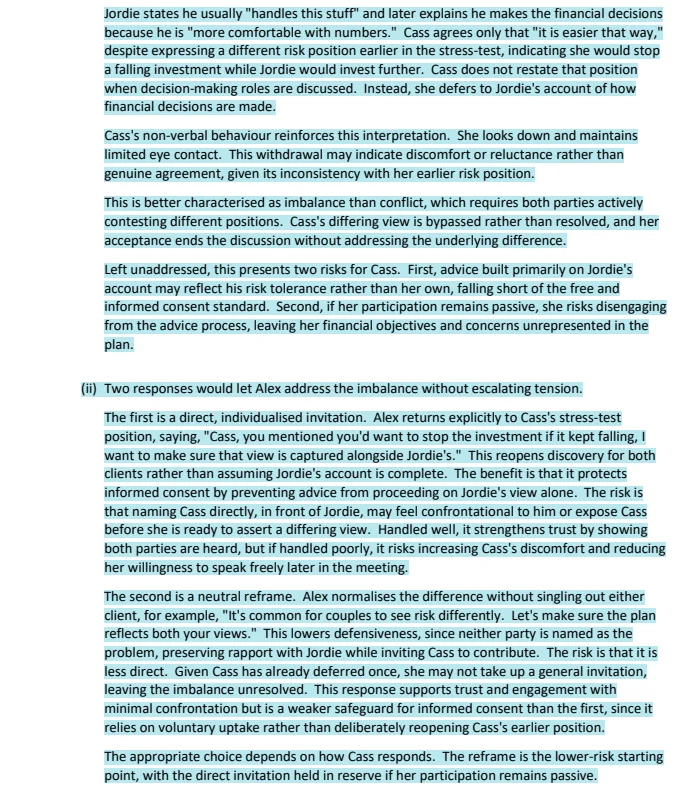
Die Prozentzahl oben leitet sich aus diesen markierten Segmenten ab: grob der Anteil der analysierten Sätze, die der Klassifikator nicht als eindeutig menschlich eingestuft hat. Deshalb kann eine komplett selbst geschriebene Arbeit einen Score ungleich null zeigen – ein paar Sätze, die zufällig glatt lesbar waren, werden markiert, der Rest nicht.
Deshalb bewegt auch die Überarbeitung eines einzigen Absatzes die Zahl sichtbar. Der Score ist eine Summe lokaler Entscheidungen, keine Eigenschaft deines Dokuments als Ganzes.
4. Warum du ein * siehst statt einer Zahl
Im AI-Writing-Panel tauchen drei Zustände auf, die Studierende ständig verwechseln.
0 % heißt: Die Arbeit wurde analysiert und nichts wurde markiert. Sauber – im engen Sinn des Detektors.
*% (ein Sternchen) heißt: Die Arbeit wurde analysiert, der markierte Anteil ist größer null, liegt aber unter der Schwelle von rund 20 %, ab der Turnitin das Signal für zu unzuverlässig hält, um es als genaue Zahl zu zeigen. Das ist kein versteckter Vorwurf; es ist die Firma, die Dozenten sagt: "niedrig genug, dass du nicht darauf reagieren solltest". Das Sternchen behandeln wir im Detail im Erklärartikel, was der Sternchen-Score bedeutet.
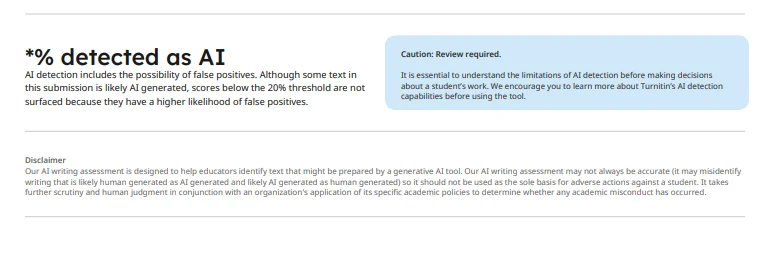
Ein grauer Gedankenstrich heißt: Der Text wurde gar nicht verarbeitet – typischerweise, weil er zu kurz ist oder zu wenig durchgehenden Prosatext enthält, als dass der Detektor analysieren könnte. Das ist kein Score von null und kein Fehler deinerseits.
5. Was Turnitin NICHT tut
Die Gerüchte sind schlimmer als die Realität. Nach dem, was Turnitin veröffentlicht hat, lohnt ein klarer Blick:
Die Erkennung liest keine Datei-Metadaten – Word-Autorenfelder, Zeitstempel –, um zu entscheiden, ob Text von einer KI stammt.
Sie erkennt nicht, ob deine *Ideen* per Prompt entstanden sind. Analysiert werden Wortmuster, nicht Gedankenquellen.
Sie bekommt kein Wasserzeichen-Signal von ChatGPT oder einem anderen Modell. Consumer-Chatbots bauen keinen nachweisbaren Marker ein, und Turnitin hat keine geheime Leitung zu OpenAI.
Sie fährt keinen einzelnen Ja/Nein-Klassifikator über das ganze Dokument. Wie oben beschrieben, fallen die Entscheidungen pro Segment.
Turnitins eigene Formulierung für all das lautet "signal, not verdict" – ein Signal, kein Urteil. Die Zahl löst die Untersuchung eines Menschen aus. Sie beendet sie nicht.
6. Der Base-Rate-Fehlschluss: Warum selbst ein guter Detektor danebenliegt
Hier die Statistik-Lektion, die dir niemand beibringt, bevor ein Vorwurf im Raum steht.
Angenommen, ein Detektor markiert fälschlich 1 von 100 menschlich geschriebenen Arbeiten. Klingt hervorragend. Angenommen zugleich, 900 von 1,000 eingereichten Arbeiten sind echt menschlich. Diese 1 % Fehler markieren immer noch 9 Mensch-Arbeiten. Sind nur 100 Arbeiten KI-geschrieben und der Detektor erwischt 80 davon, dann sind 9 der 89 markierten Arbeiten unschuldig – rund 1 von 10 Markierungen ist falsch.
An der Mathe ist der Detektor nicht schuld. Menschtext ist schlicht sehr viel häufiger als KI-Text, deshalb erzeugt schon eine winzige Fehlerrate auf der großen Mensch-Population eine spürbare Zahl falscher Markierungen. Das ist der Base-Rate-Fehlschluss, und deshalb ist ein markierter Satz ein verwertbares Indiz, kein Beweis.
Falls dich je eine Falschmarkierung erwischt: deine Entwürfe, dein Versionsverlauf, deine Gliederung und die Fähigkeit, dem Professor den Entstehungsweg deiner Arbeit zu erklären, sind mehr wert als jeder Score.
7. So siehst du dieselbe Bewertung bei deiner eigenen Arbeit
Über deinen KI-Score kannst du nicht abstrakt räsonieren. Du musst sehen, welche *deiner* Sätze markiert werden – vor der Abgabe, im echten Report, den dein Professor sehen wird.
Genau das macht InDetect: Deine Arbeit läuft über autorisierte Dozentenkonten mit Null-Repository-Speicherung, die echte Turnitin-Engine wird darauf losgelassen, und du bekommst den vollständigen Similarity- und AI-Report in 5–30 Minuten. Arbeit und Report werden innerhalb von 24 Stunden gelöscht. Wir halten keine Datenbank, dein Vorschaureport kann also nie mit deiner Abgabe kollidieren. Den echten Ablauf zeigen wir Schritt für Schritt im Test des Service, den Vergleich mit anderen Optionen im Ratgeber zu Turnitin-Checker-Tools. Die Engine haben wir auch gegen Modelltext laufen lassen – im Test Gemini vs. ChatGPT vs. Claude.
8. FAQ: So funktioniert Turnitins KI-Erkennung
Prüft Turnitin die ganze Arbeit oder Satz für Satz? Die Analyse läuft in Segmenten, jedes wird einzeln markiert. Die AI-Writing-Prozentzahl oben ist der markierte Anteil des analysierten Textes – die Dokumentzahl ist also eine Summe von Entscheidungen auf Satzebene.
Was bedeuten die gelben und violetten Markierungen im AI-Report? Sie unterscheiden vollständig markierte Passagen (wahrscheinlich KI-generiert) von teilweise markierten (vielleicht gemischt aus Mensch und KI) – gemäß Turnitins offizieller Report-Legende. Die Farben im Text entsprechen den Kategorien im Bewertungspanel.
Warum zeigt mein Turnitin-KI-Score ein Sternchen statt einer Zahl? Weil der markierte Anteil unter der Schwelle liegt (rund 20 %), ab der Turnitin eine genaue Zahl für aussagekräftig hält. Ein Sternchen heißt: niedriges, aber nicht null Ergebnis – keine versteckte Strafe.
Kann Turnitin bei menschlichem Text falsch liegen? Ja. Weil Mensch-Arbeiten KI-Arbeiten haushoch überwiegen, erzeugt selbst eine niedrige Falsch-Positiv-Rate eine reale Zahl zu Unrecht markierter Studierender. Turnitin selbst rahmt den Score als Signal für eine Nachprüfung, nicht als Urteil.
Ändern Formatierung oder Grammarly-Tools den KI-Score? Formatierung allein nicht. Überarbeiten kann schon – weil der Score aus statistischen Mustern auf Satzebene kommt, kann das Glätten deines Stils mit einem aggressiven Umformulierungstool verschieben, welche Sätze markiert werden.
9. Fazit: Ein Satz-Klassifikator, kein Gedankenleser
Turnitins KI-Erkennung bewertet Segmente, addiert sie zu einer Prozentzahl, versteckt die Zahl unterhalb von rund 20 % und verweigert die Verarbeitung zu kurzer Texte. Sie liest statistische Textur, nicht Absicht – und selbst ein sauber gebauter Klassifikator liegt bei Menschtext wegen der Base Rates daneben.
Wenn du wissen willst, wie deine Sätze tatsächlich markiert werden, lass die echte Engine vor der Abgabe einmal laufen. Bei InDetect gibt es für berechtigte Neunutzer einen Gratis-Check (Verfügbarkeit hängt von deinem Land ab); Lite kostet $9/Monat und deckt 2 Checks ab ($4.50 pro Arbeit), der Report kommt in 5–30 Minuten.